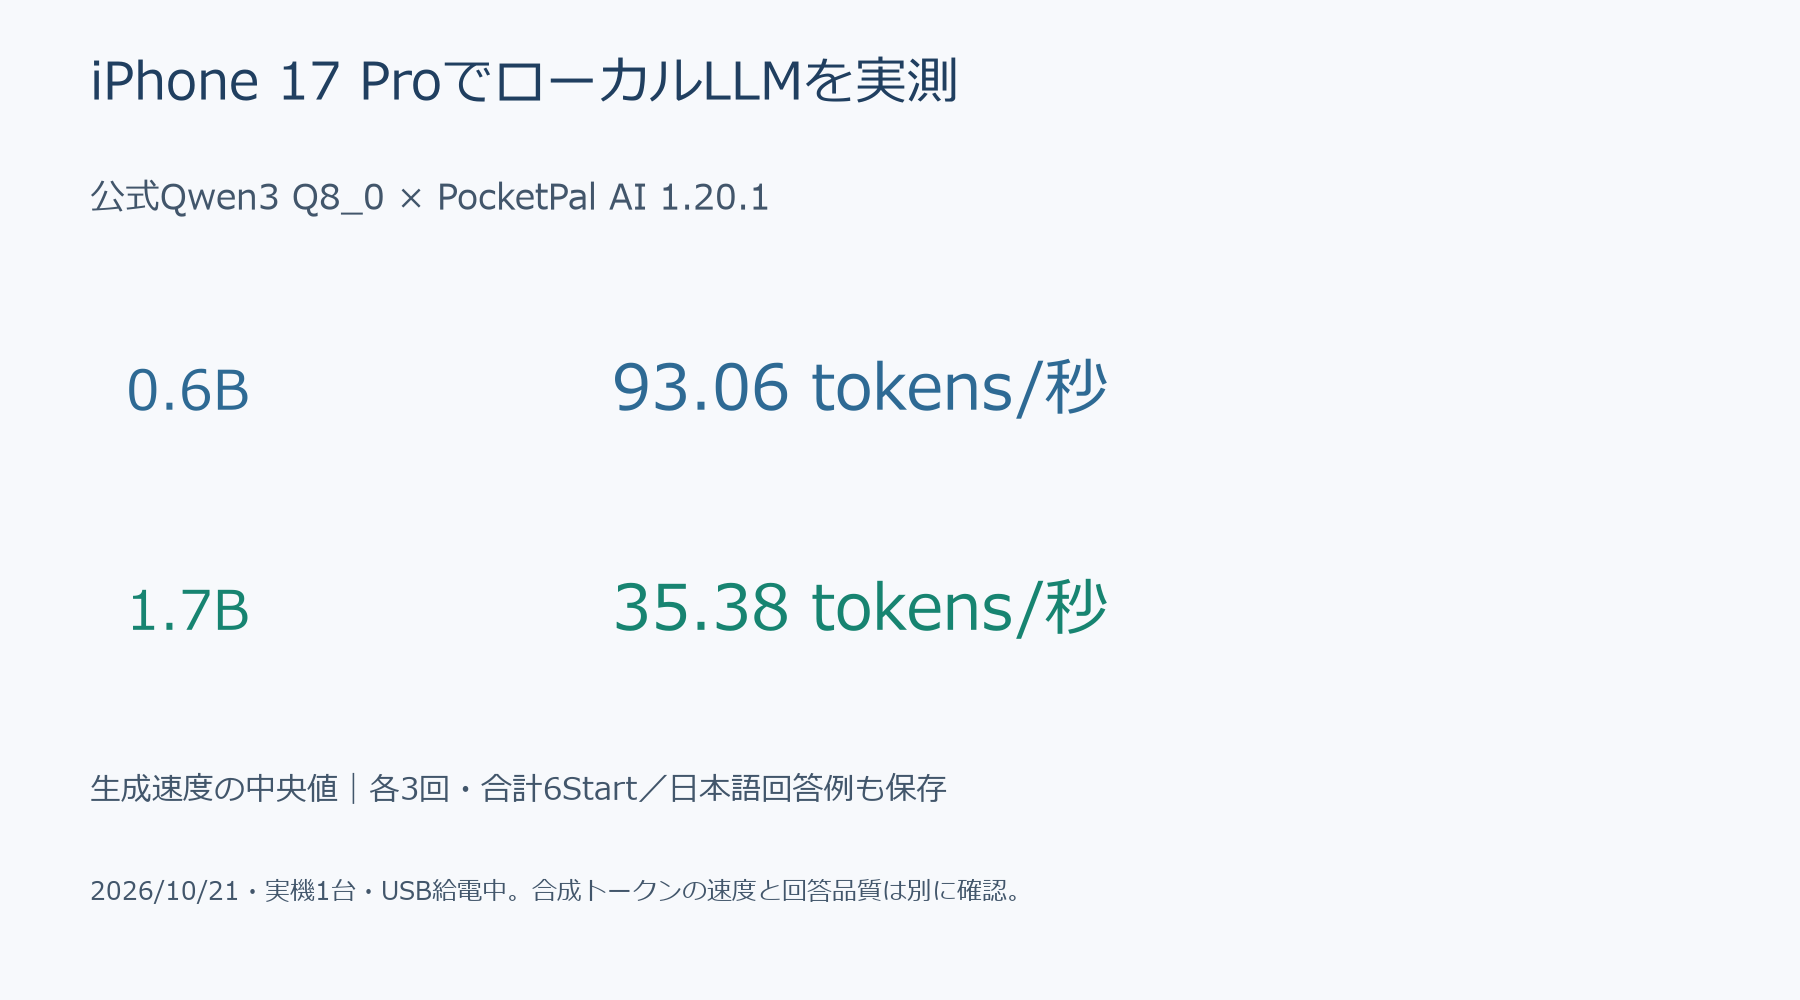
iPhone17Proにモデルを保存して、ローカルLLMを動かせるのか。手元の256GB実機でPocketPal AIを使い、公式Qwen3の0.6Bと1.7B、いずれもQ8_0を読み込み、速度ベンチマークと日本語の回答生成を確認しました。
2026年10月21日に各モデル3回、合計6回の「Start Test」を実行。生成速度の中央値は0.6Bが93.06 tokens/秒、1.7Bが35.38 tokens/秒でした。0.6Bの日本語回答には「手札(手札)」という不自然な持ち物も出ています。処理速度の数値と、返ってきた文章の両方を原本画像・CSVで示します。
iPhone17ProのローカルLLMは動いた?2モデルの結果
| 公式モデル(Q8_0) | 生成速度TGの中央値 | 3回の範囲 |
|---|---|---|
| Qwen3 0.6B | 93.06 tokens/秒 | 92.79~93.24 |
| Qwen3 1.7B | 35.38 tokens/秒 | 35.20~35.46 |
どちらもモデルの読み込みとベンチマークが完了し、別途、日本語の質問を1回ずつ送り、回答の生成まで確認できました。今回の条件では0.6Bの生成速度が高い結果です。ただし、この表は合成・ランダムトークンのベンチマークであり、日本語の文字数を1秒で何文字書けるか、質問に正しく答えられるかを測った表ではありません。
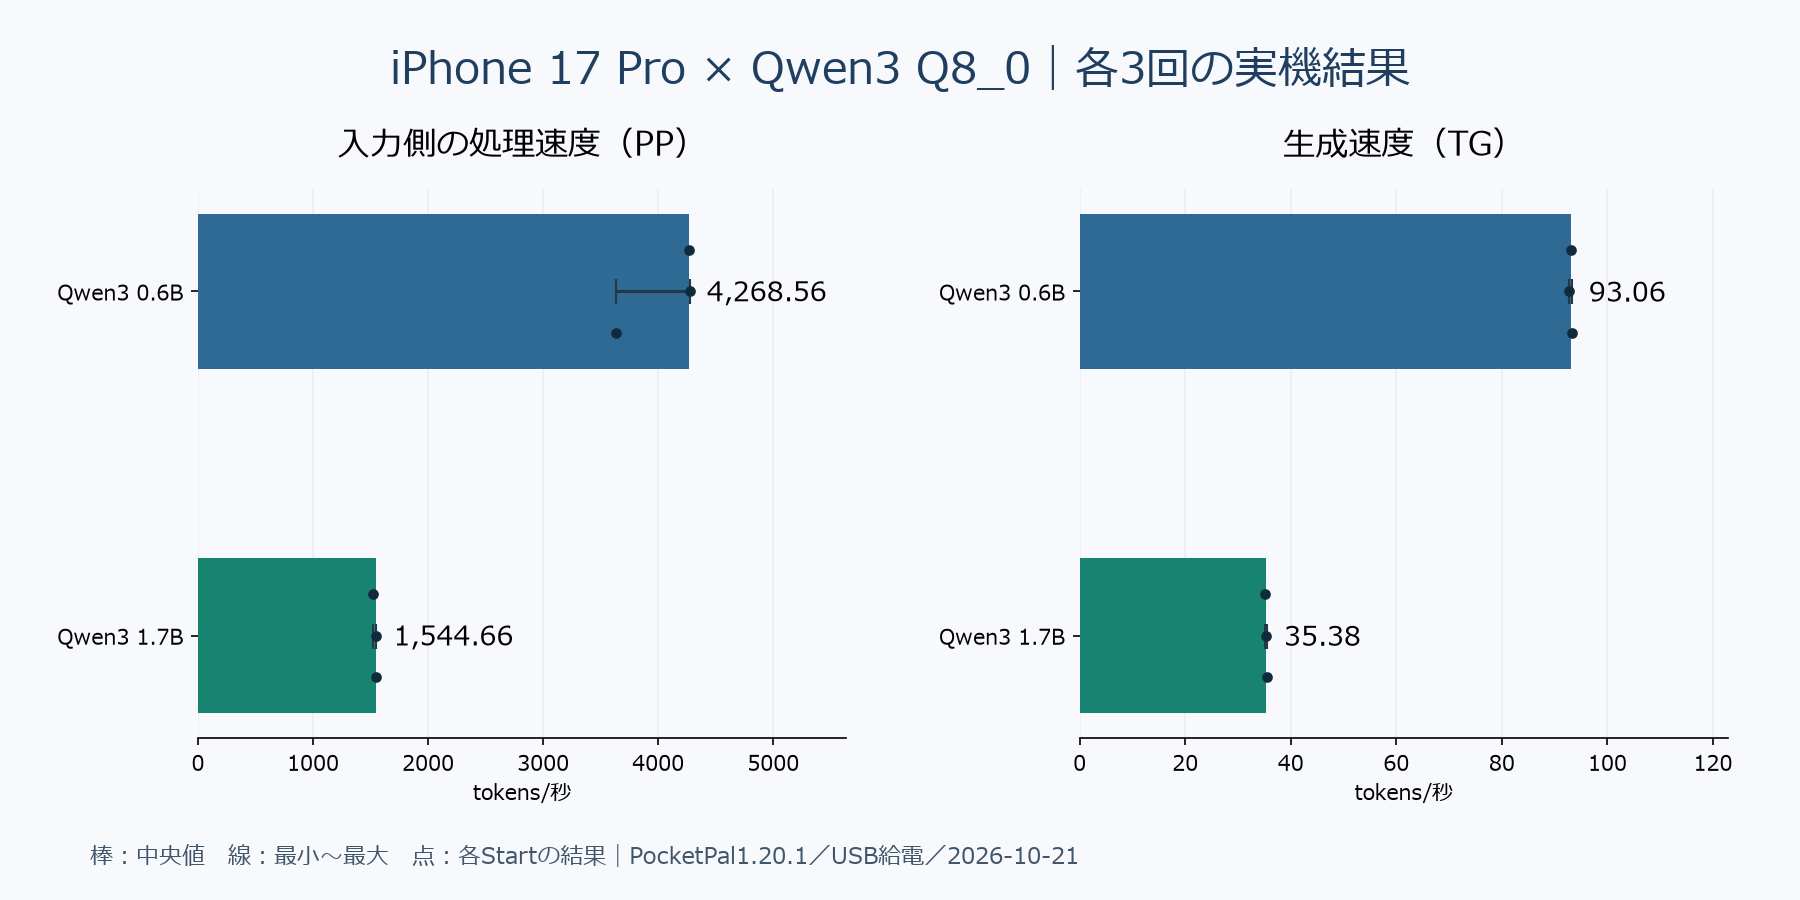
入力側を処理するPPの中央値は0.6Bが4,268.56、1.7Bが1,544.66 tokens/秒でした。PPとTGは仕事の内容が異なる指標です。同じ端末でも、モデル、量子化、入力や出力の長さ、アプリ設定によって結果が変わります。今回の数値を、別条件のPCやクラウドAIのスコアへそのまま当てはめて比較してはいません。
6回すべての数値と、実際の結果画面
測定順は0.6B→1.7B→1.7B→0.6B→0.6B→1.7Bとし、開始前に選択したモデルを読み込み、毎回60秒以上休止しました。0.6Bの初回PPは3,635.53で、その後の2回より低くなりましたが、原因は特定していません。初回を削除せず、全件を集計しています。
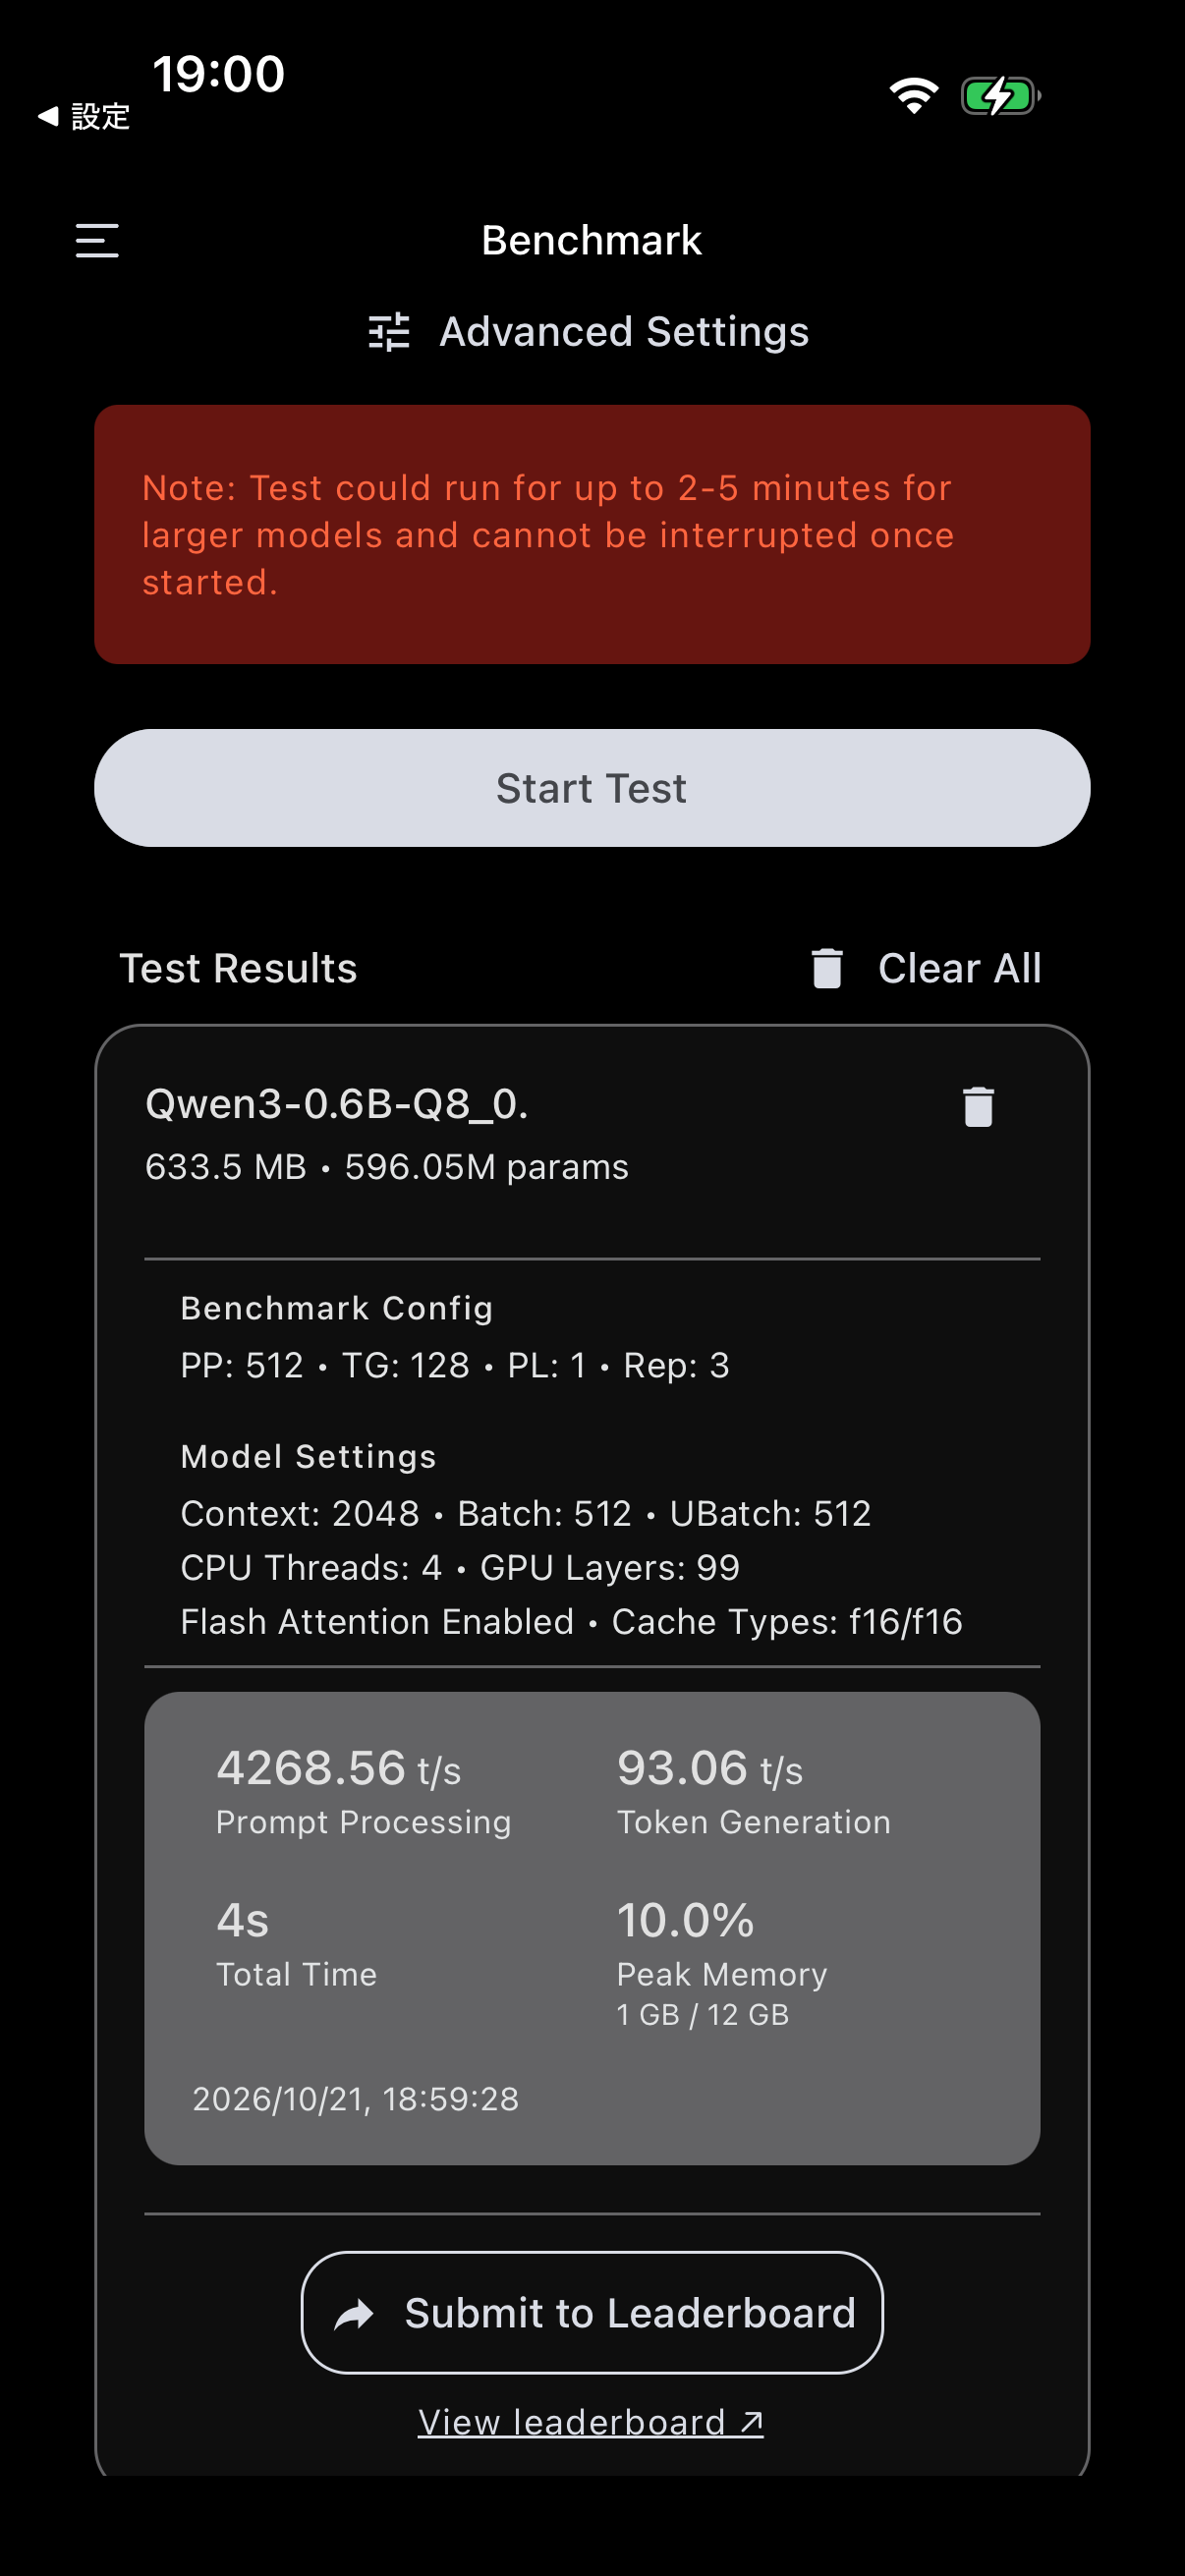
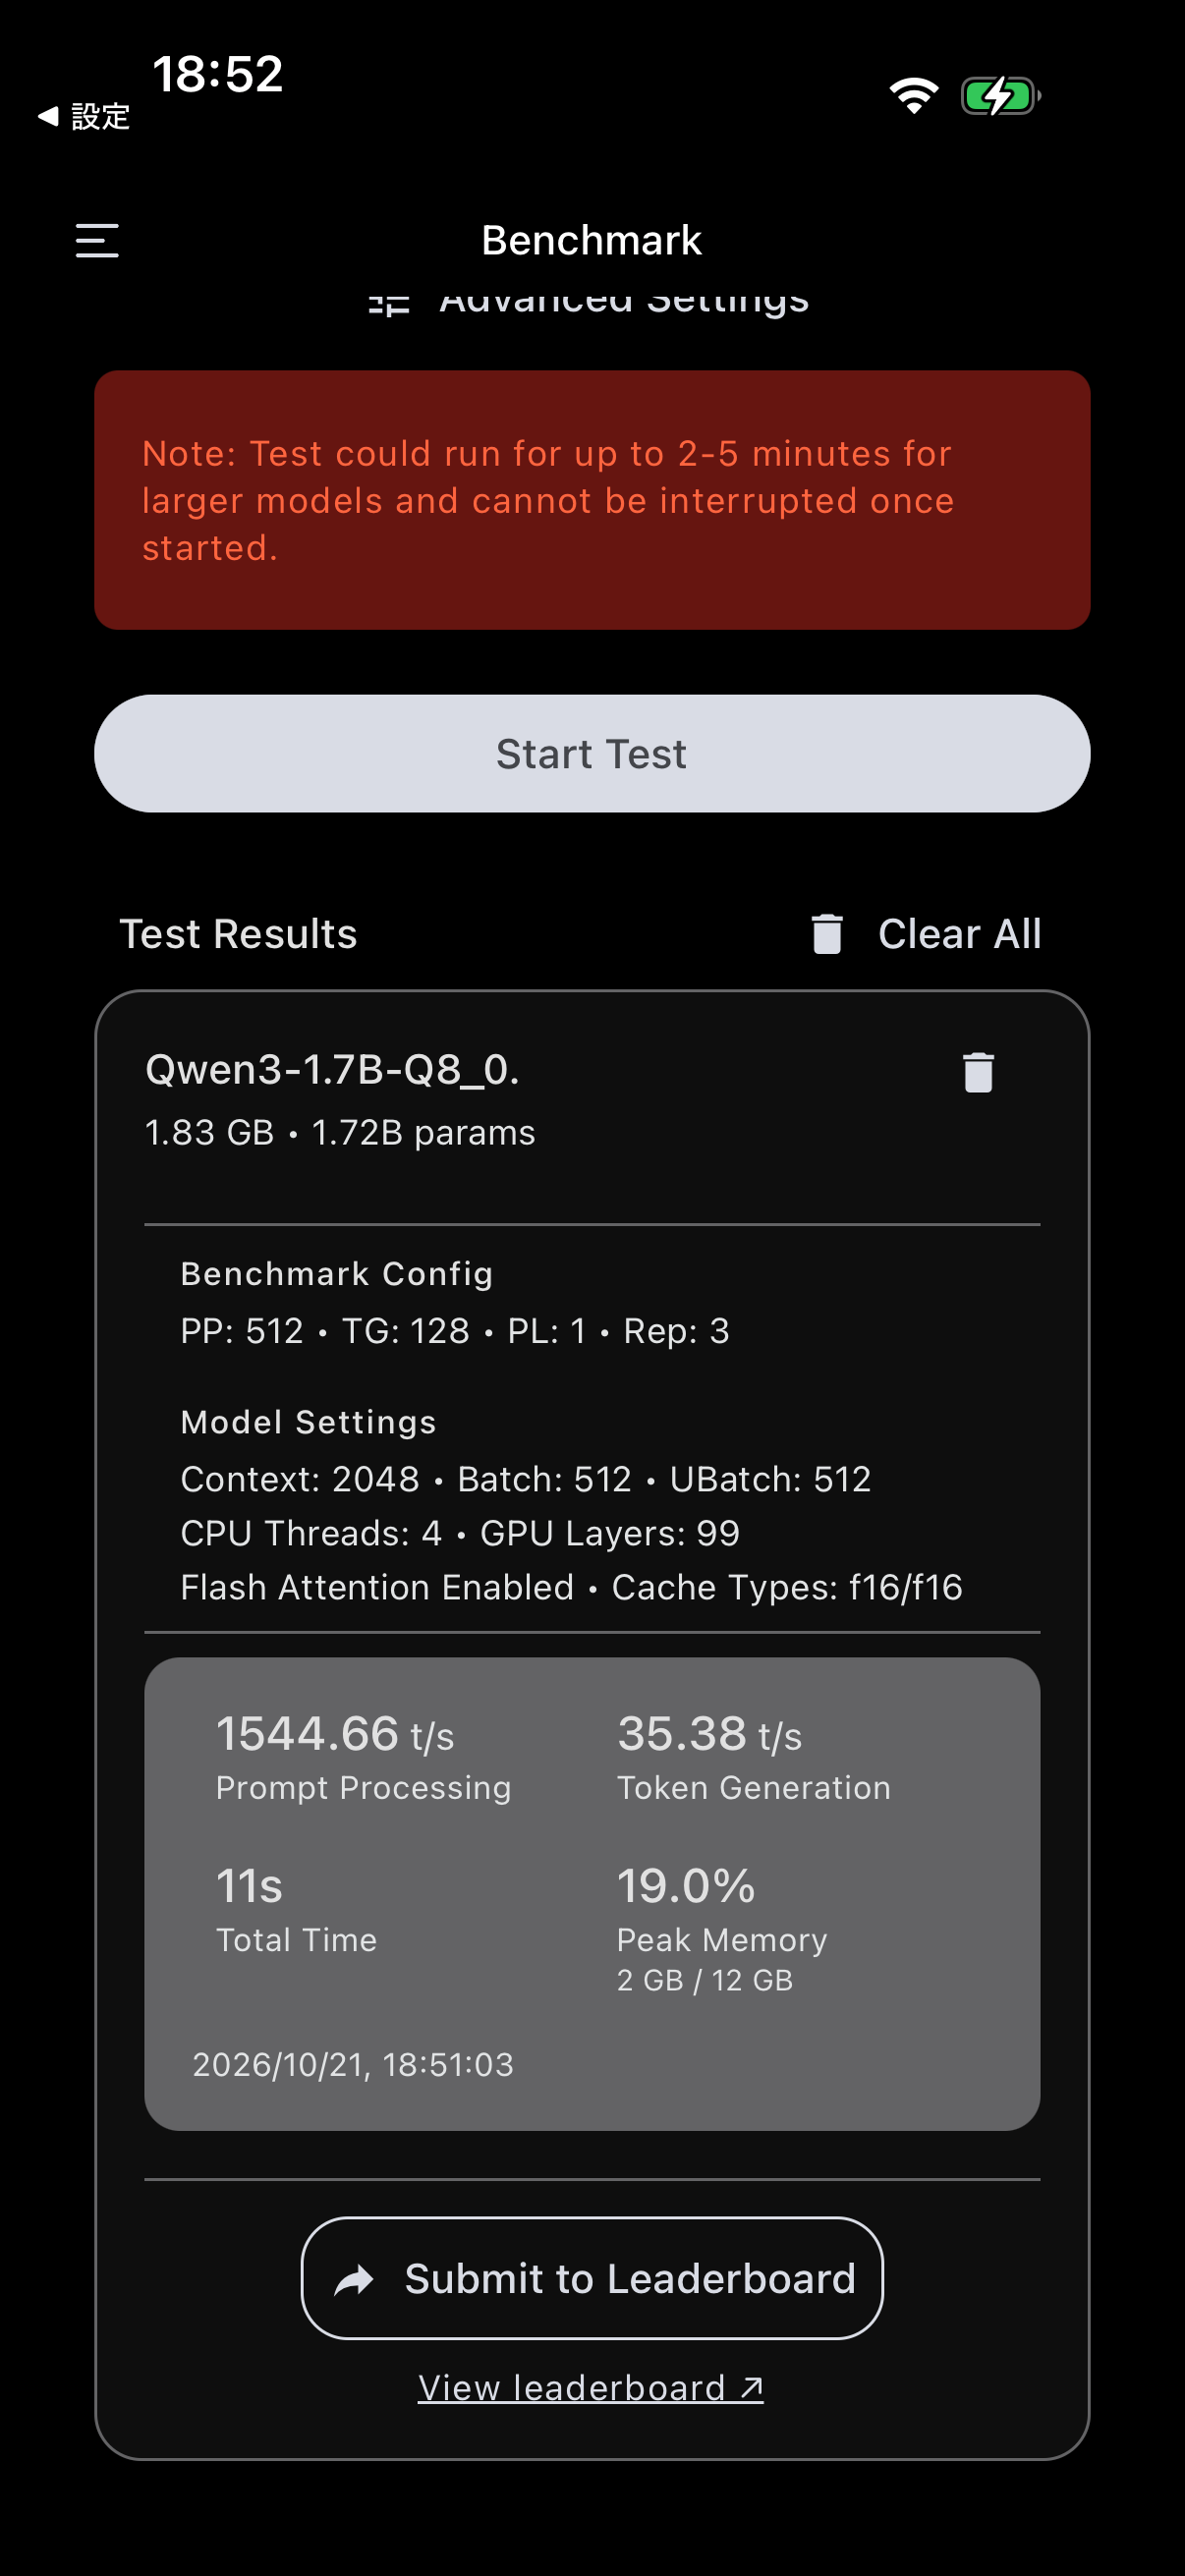
「Total Time」の4s、11s、12sはアプリの表示値です。モデルのダウンロードや、測定前に行ったロード・休止の所要時間ではありません。また、各Startの設定にあるRep:3(NR3)はアプリ内の内部反復で、今回の「各モデル3回のStart」とは区別しています。18回の独立試行として集計していません。
日本語の回答はどうだった?同じ質問を1回ずつ送信
速度の測定後、新しい空の会話を使い、思考モードをOffにして、同じ質問を1.7B→0.6Bの順に1回ずつ送りました。入力は「日帰り旅行の持ち物を3つだけ、日本語の箇条書きで教えてください。」です。回答の選び直しや再生成はしていません。
| モデル | 今回返った3項目 | この1例で観察したこと |
|---|---|---|
| 1.7B | 軽い鞄またはバックパック/水分(水や電解質飲料)/昼食(軽食や惣菜) | 日本語の3項目の箇条書きが返った |
| 0.6B | 手札(手札)/携帯電話/パス・カード | 番号付き3項目に加えて前後の説明文も出た。「手札(手札)」という不自然な語を含む |
0.6Bは速く生成できましたが、今回の回答には持ち物として意味の取りにくい語が入りました。「手札」を「財布」へ直すなどの編集はしていません。一方、1.7Bのこの回答は3項目の箇条書きとして返りました。各1問の例だけで、日本語能力全体の優劣や回答の正確性を順位付けしたものではありません。
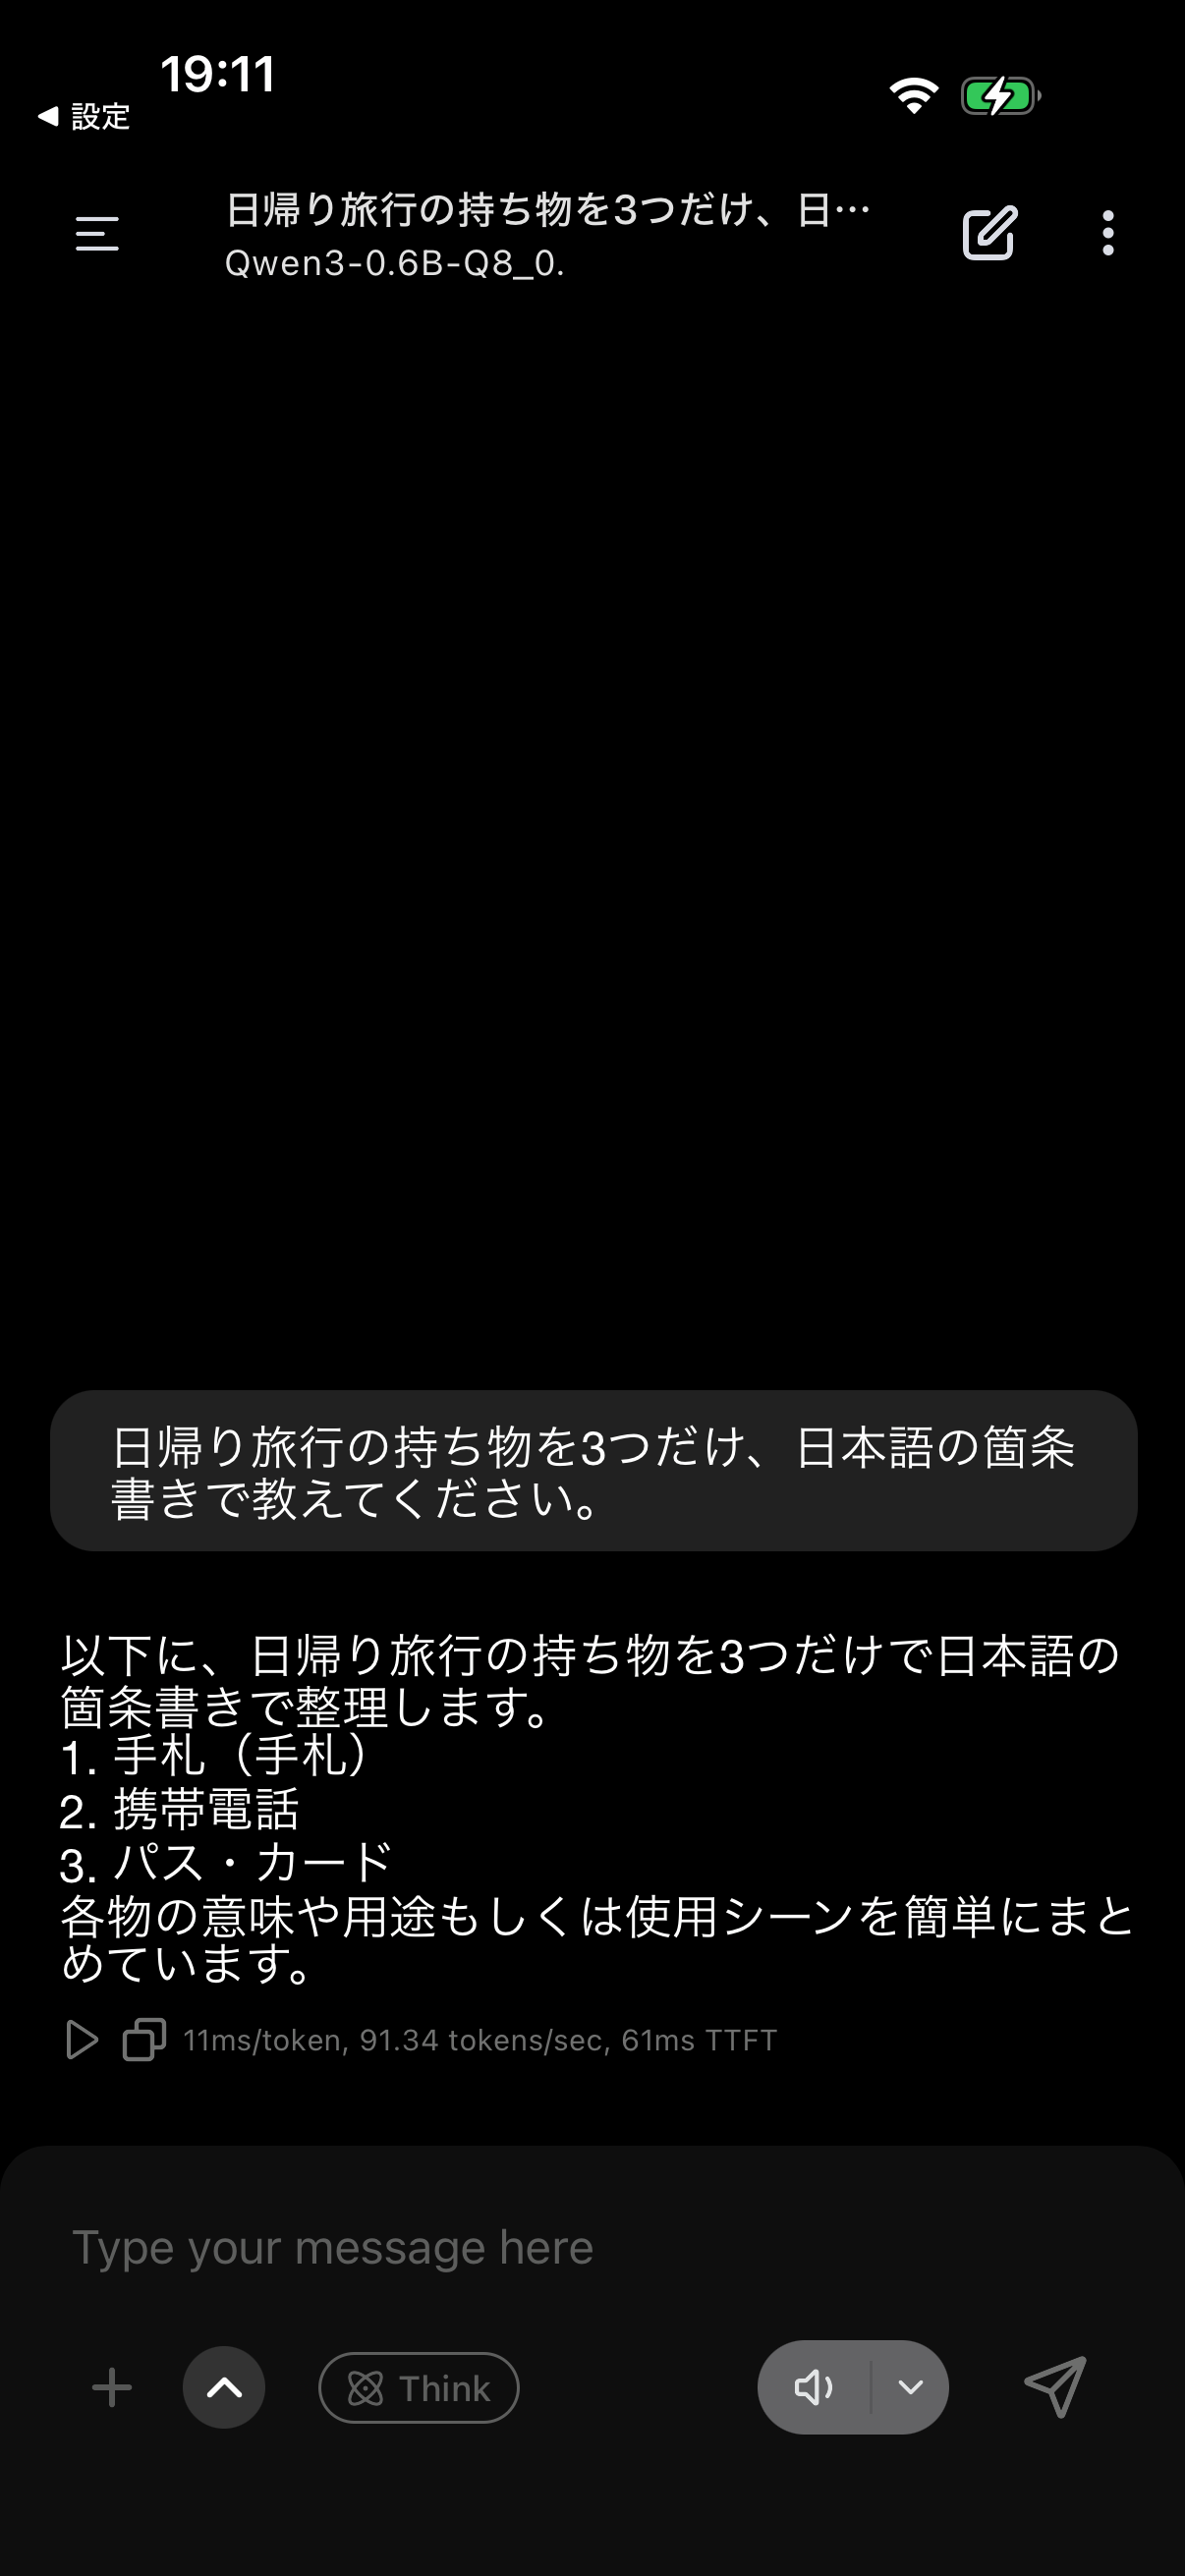
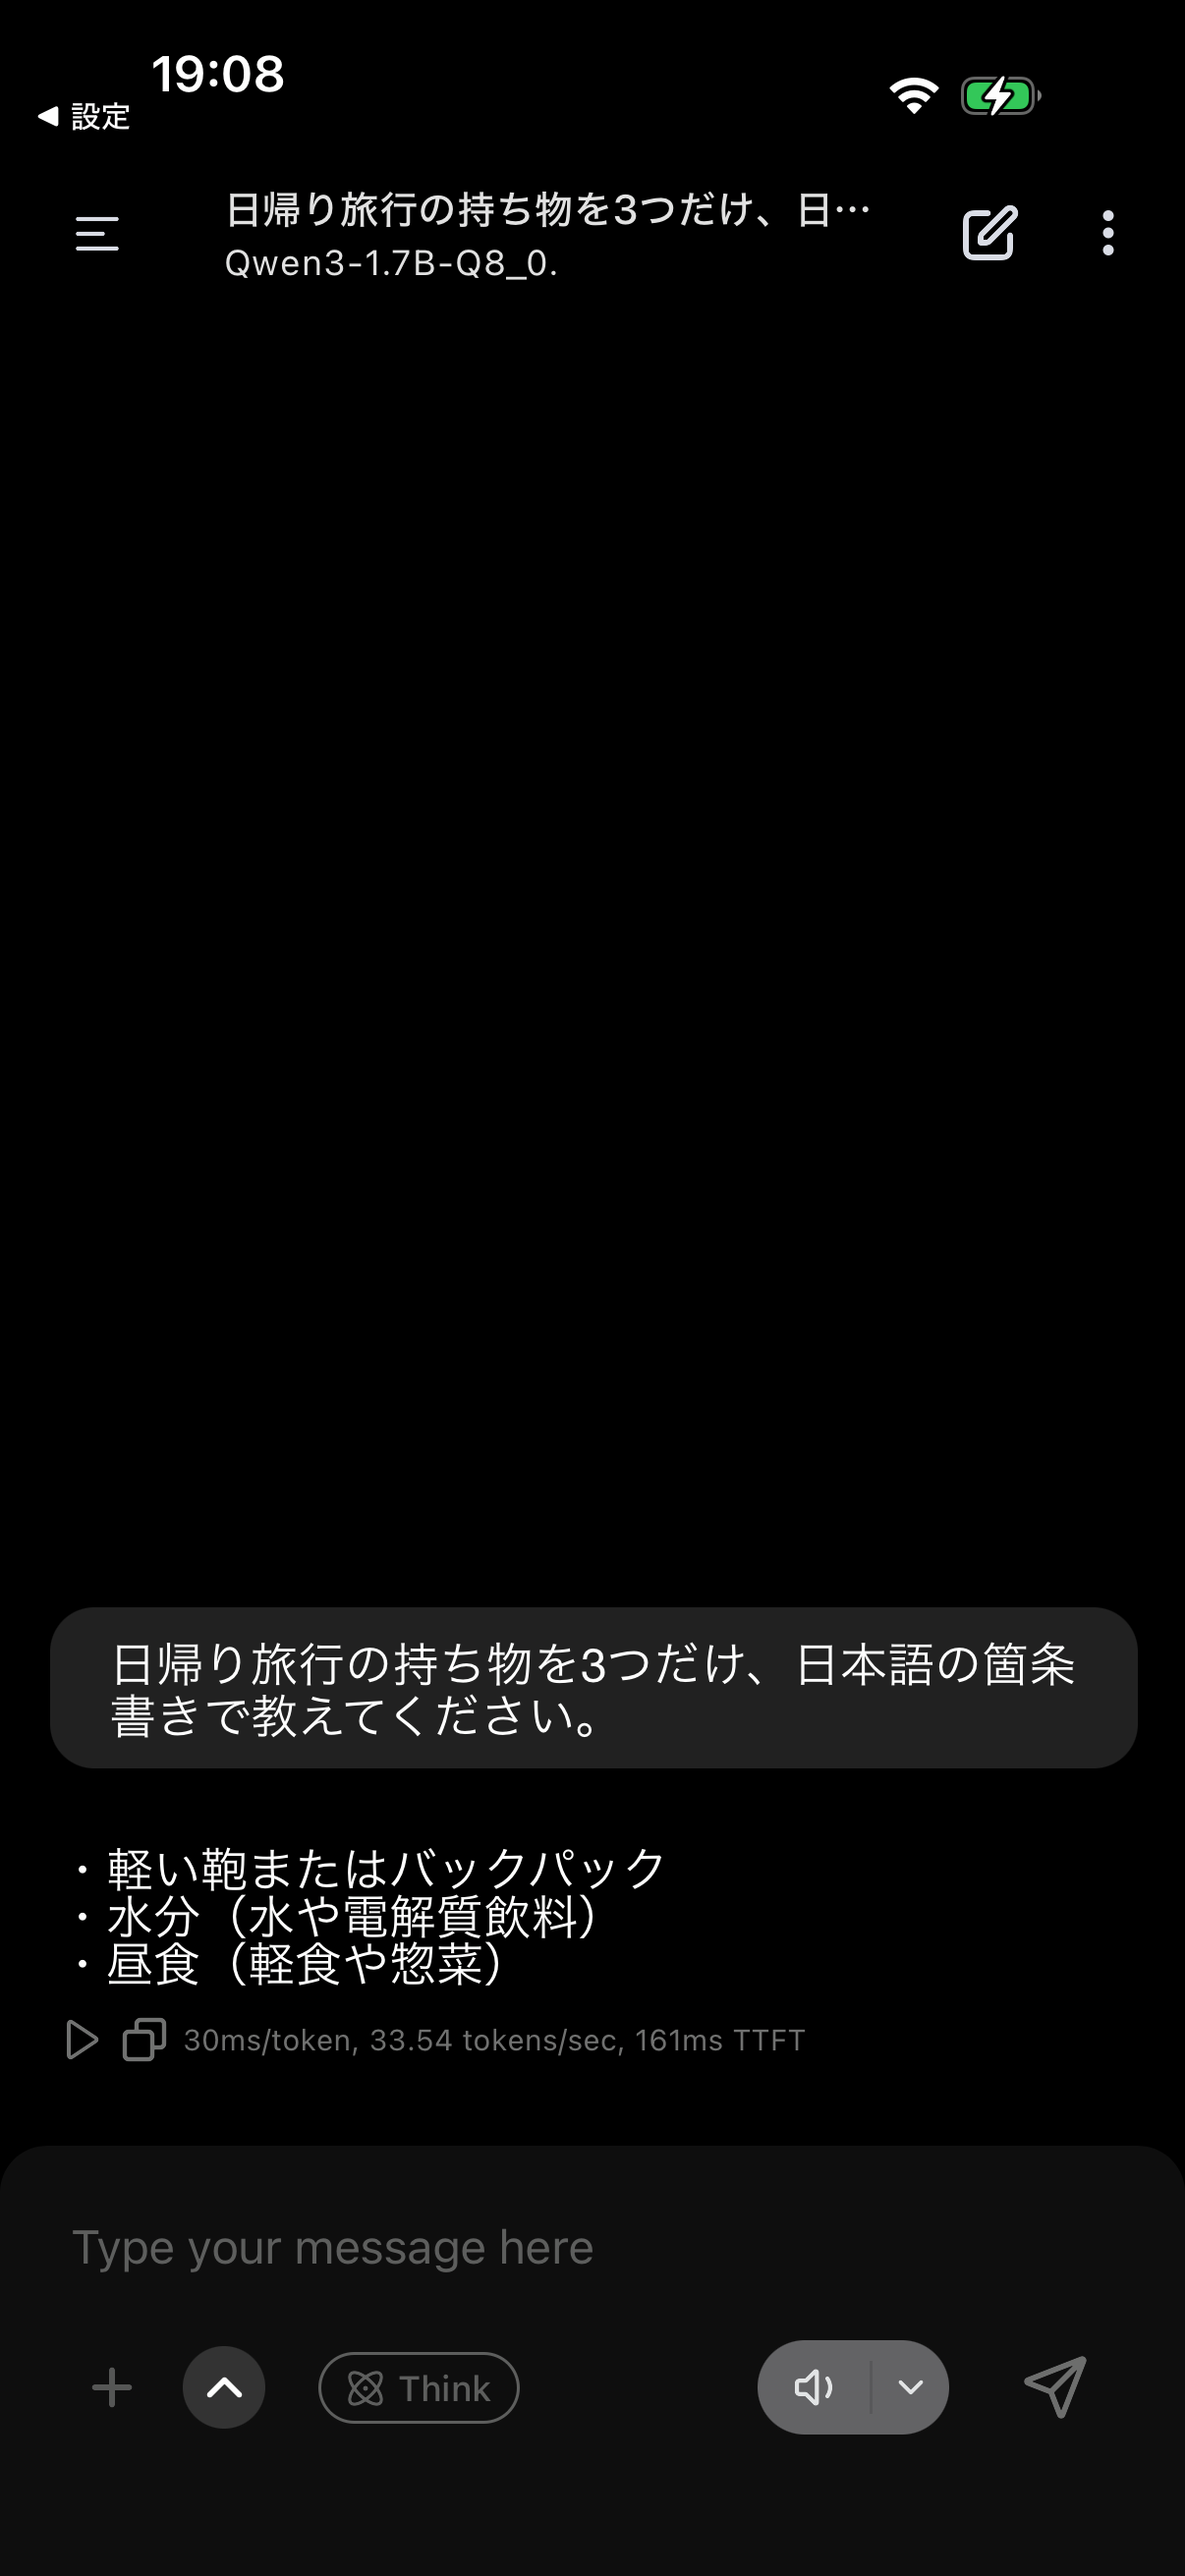
画面下部のtokens/secやTTFTは、その1回答に対してアプリが表示した値です。上の合成トークンのベンチマークとは入力・出力条件が異なり、6回の集計へ混ぜていません。日本語例ではサンプリング設定の変更はしていませんが、温度などの数値を個別に確認していないため、厳密な回答品質比較の再現条件としては限定的です。
今回の入れ方:公式モデルを選んでダウンロードし、Load
使用したのはApp StoreのPocketPal AIです。実際にインストールされたバージョンは1.20.1(build152)。有料追加機能は使っていません。アプリ内のModelsで+を開き、「Add from Hugging Face」からモデルを検索し、作者がQwenの公式リポジトリを選びました。
今回のファイルは、Qwen3-0.6B-Q8_0.ggufと、Qwen3-1.7B-Q8_0.ggufです。同じ名前に似た別作者の変換版も検索結果にあったため、作者・ファイル名・量子化を確認して取得しています。今回はQ4_K_Mなど他の量子化は試していません。
取得後はModelsの「Ready to Use」で確認し、「Load」で読み込みました。今回の公開モデルは、Hugging FaceへのログインやAPIキー入力、リモートサーバー設定を使わずに進められました。アプリの入手時に行うApp Storeの認証とは別の話です。モデルの取得には通信が発生するため、実験では定額Wi-Fiを利用しています。
モデルの容量と、画面のPeak Memoryは同じ数値?
モデル取得画面の容量表示は0.6Bが639MB、1.7Bが1.83GBでした。0.6BのReady欄では639.45MB、読み込み後のモデル情報・結果欄では633.5MBという別の表示も観察しています。これらは各画面に出た値として区別しており、モデル取得前後の端末空き容量の差を測った数値ではありません。
結果画面のPeak Memoryは、0.6Bで10.0~10.3%(丸め表示1GB/12GB)、1.7Bで18.9~19.8%(同2GB/12GB)でした。これはアプリのメモリ表示です。ファイルの容量や、端末に搭載されたRAMそのものを物理的に測った値とは区別します。表示の丸めや取得間隔の影響もあるため、この値だけから大きな別モデルの動作可否を保証していません。
RAMの表示単位についてはiPhone17Proのメモリ表示を複数アプリで確認した実測記事、本体容量の選び方は256GBモデルの容量実測記事へまとめています。今回の2モデルが動いたことだけで、7Bなど大きなモデルも同条件で使えるとは判断していません。
測定条件・回数・終了後の状態
| 項目 | 今回の条件 |
|---|---|
| 実機・日付 | 利用中iPhone17Pro 256GBを1台/2026年10月21日 |
| OS・アプリ | 端末報告iOS26.6.1(23G83)/PocketPal1.20.1 build152 |
| 電源・室温 | WindowsへUSB接続・給電維持/室温とケースは当日未確認 |
| 電力・表示 | 適応型電力On、低電力モードOff、フレーム制限Offの原値を維持 |
| ベンチ設定 | PP512/TG128/PL1/NR3 |
| モデル初期化 | Auto/Context2048/Batch512/UBatch512/CPU threads4/GPU要求値99 |
| 結果欄の表示 | Flash Attention Enabled/Cache f16・f16 |
| 休止と回数 | 各開始前60秒以上休止/各モデル3Start、計6Start |
| 日本語例 | 各モデル1問、新しい会話、思考Off。速度ベンチ6件とは別 |
GPU Layers99はアプリの設定・結果欄の値で、搭載GPUのコア数を数えた結果ではありません。休止時間は設けましたが、開始時の温度を厳密に一致させた比較ではありません。長時間の連続生成、実放電の電池持ち、表面温度、ほかの端末との比較は未試験です。
測定前の準備で操作用サービスが一度応答停止し、そのサービスだけを再起動しました。その時点のベンチ結果は0件で、上の全6回は復旧後に実行したものです。終了後は各日本語例で変更した思考モードの元のOnを確認し、推論アプリを終了。19:14に電力・フレーム制限の原値一致とUSB給電を確認しました。モデルファイルと自分の試験用会話は端末に残しています。
オフライン動作やChatGPTとの比較は、どこまで分かる?
PocketPalの公式説明とプライバシーポリシーでは、コアの推論を端末内で行う仕組みが説明されています。今回もローカルモデルを読み込み、リモートAPIの設定を使わず実行しました。ただし、Wi-Fi接続は維持しており、ネットワークを切り離した再現試験は行っていません。
提供元のベンチマーク説明でも、合成トークンの処理速度と自然文の使い勝手は別の指標として扱われています。ChatGPTなどのクラウドAIとは同じ質問・モデル・計測方法で比較していないため、今回のtokens/秒だけで優劣を決めていません。利用する文章の種類や回答内容も確認することが、購入前の判断材料になります。
iPhone17Pro購入前に確認したい、ほかの実測
今回の結果は、手元の17Proで2つの小型モデルが動き、モデルによる速度差と日本語回答の具体例を確認できた記録です。処理性能以外も含めて判断したい場合は、iPhone17Proの総合実測レビューから、USB転送、Wi-Fi、低電力モードなどの実験をご覧ください。
AmazonでiPhone17Pro本体の価格・在庫を確認する
広告リンク。検索結果には別モデルやアクセサリーも含まれます。容量、販売元、新品・中古、保証・返品条件を確認してください。
全6回のCSV・日本語回答・原本画像をダウンロード
ZIPには、6回のベンチマークCSV、日本語回答2件のCSV、原本スクリーンショット8枚、事前条件、集計、復元照合、参照先を収録しています。ベンチCSV6行とチャットCSV2行は異なる試験で、8回の速度試験として合算していません。モデル本体やApp Store認証画面、端末識別子、個人データは配布していません。
iPhone17ProのローカルLLM実測データをダウンロード(ZIP・CSV・原本画像8枚)
実測・画面記録:ガジェ侍。実施日・公式情報参照日:2026年10月21日。実機1台、2モデル各3Start、日本語例各1問の記録です。
コメント